Agent自进化(更新中)
Agent自进化过程的论文调研
1. 自我反思与语言强化
1.1 Reflexion
提出了语言强化学习的概念
普通强化学习是依靠数字“奖励”,数字虽然方便但包含的信息太少了,故Reflexion把反馈(成功/失败,或者一个分数,甚至一段文字)放大成一段自然语言反思,存进记忆里,供下一次尝试使用。
典型流程
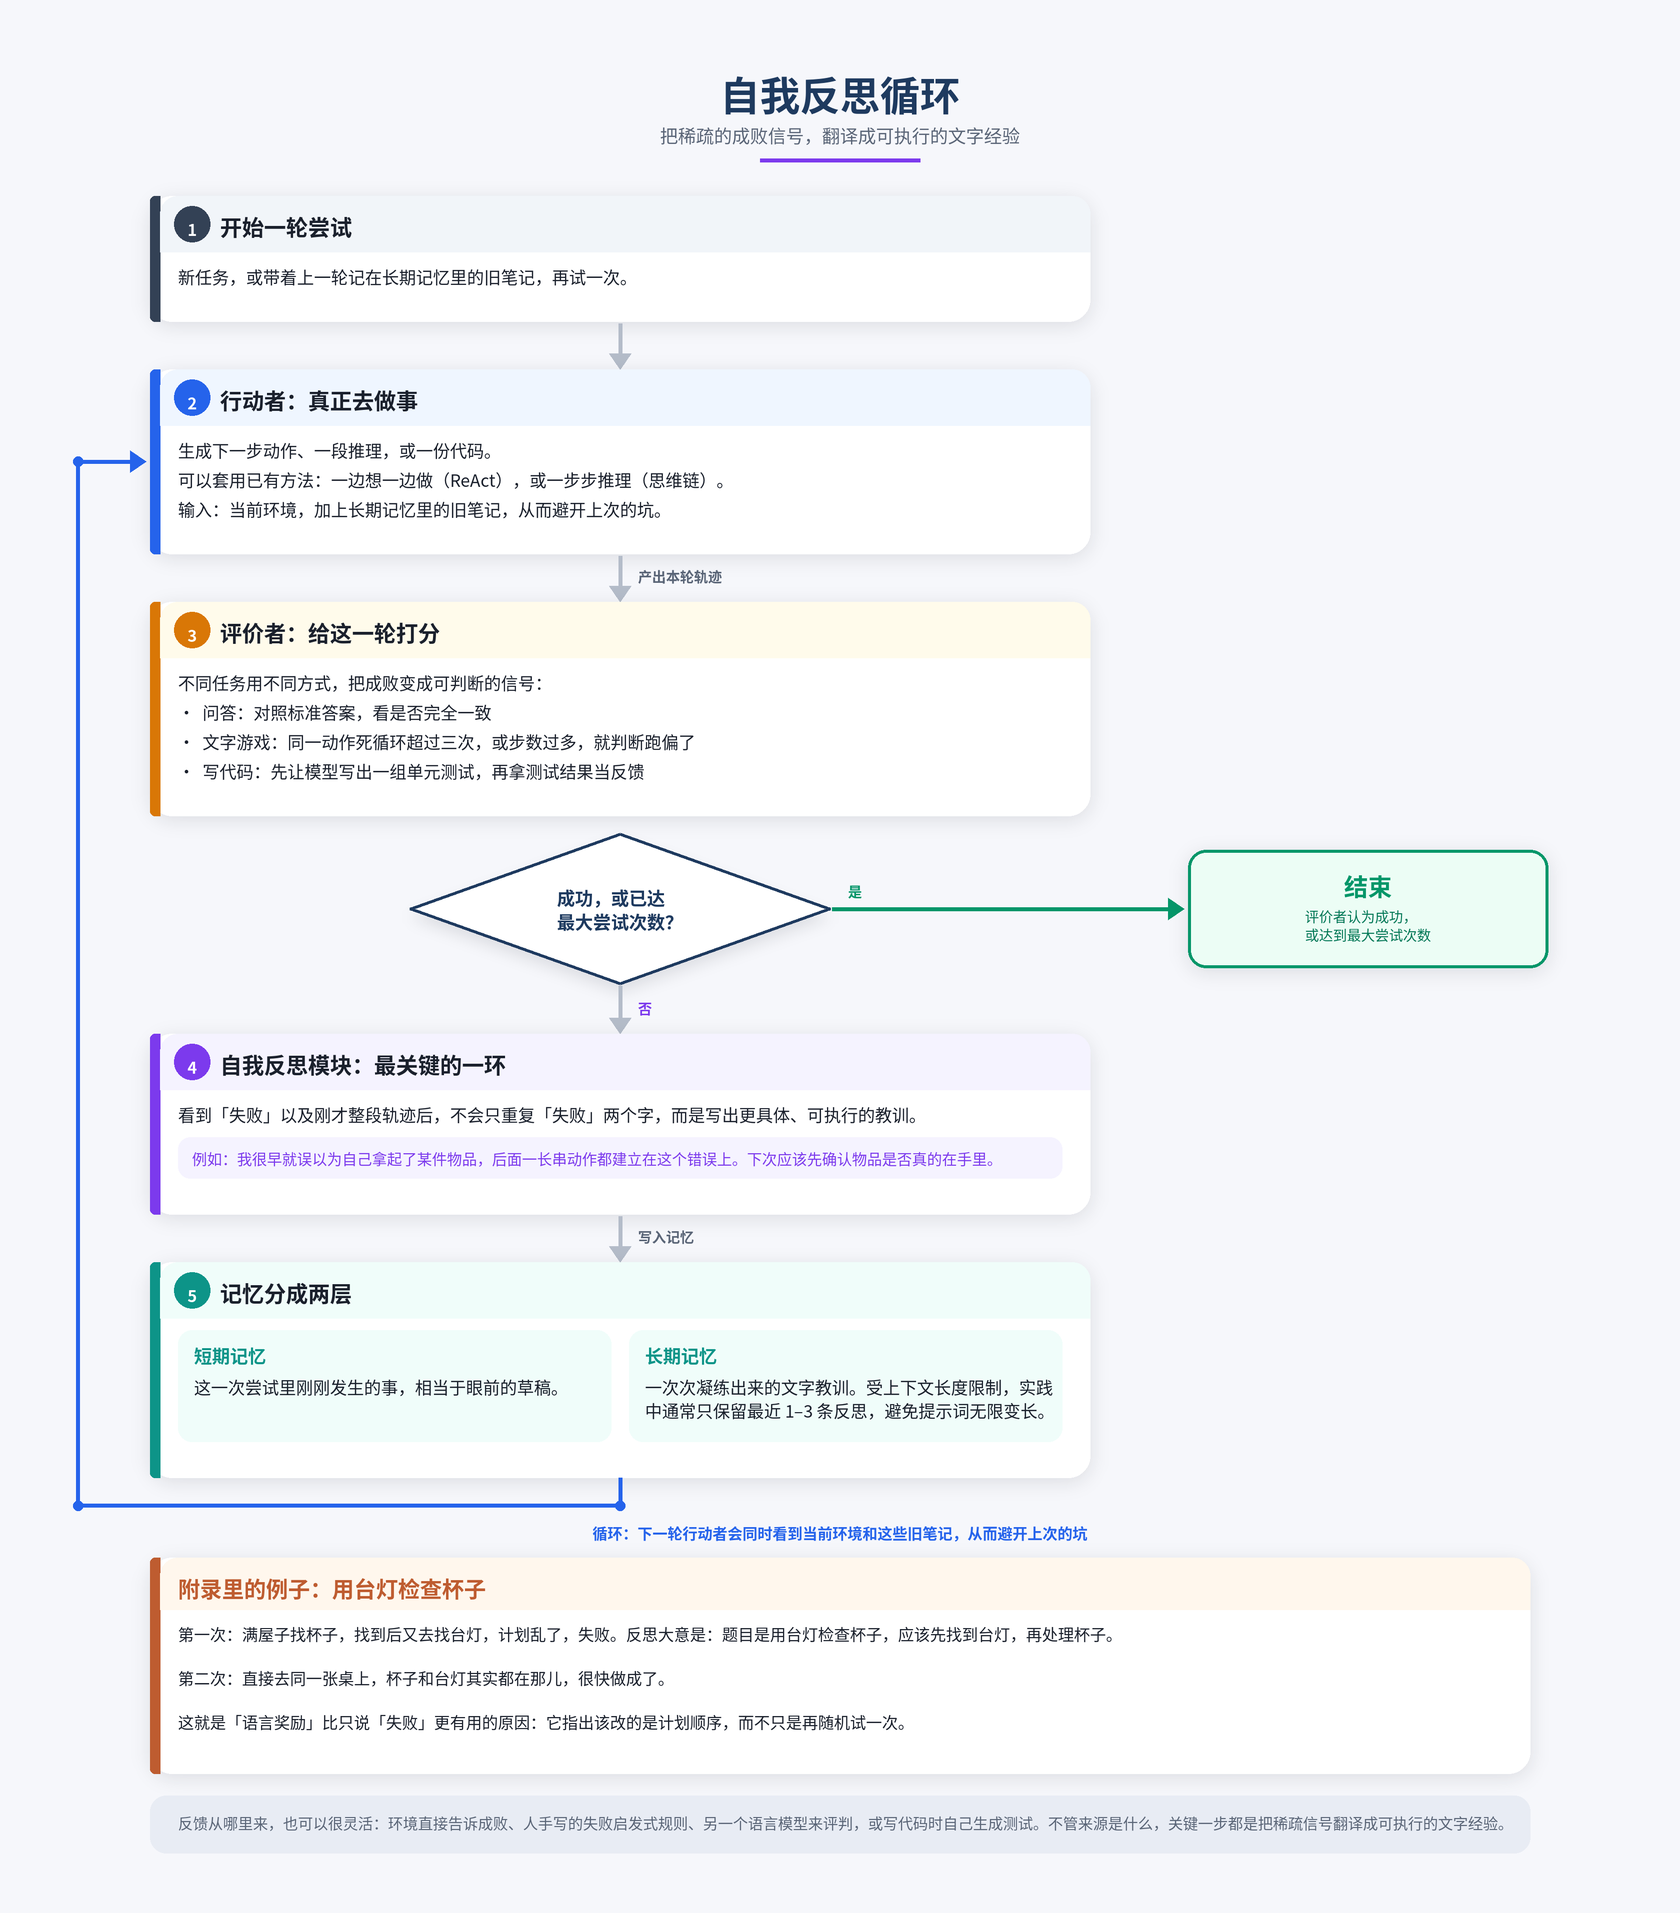
优点和局限性
- 优点: 轻、不用微调大模型,反馈可以来自外部或自己模拟,改进过程可检查
- 局限:
- 依赖大模型自评或启发式规则的质量,可能在局部最优里打转。
- 长期记忆只是一个滑动窗口,装不下太多教训。
- 写代码时,它还受自制测试质量的束缚。
2. 经验记忆与技能库
2.1 Voyager
更早的做法常常是人工设定某一个固定目标,比如“去挖钻石”,或者每次都从零开始、不把上一次学会的技能干净地带回来。这样的智能体不像在持续成长,更像在反复挖坑。Voyager 想做的,是第一个在这个世界里能够终身学习的大模型具身智能体:自己决定下一个值得尝试的目标,把学会的本事存起来,出错就改代码,看到新环境时还能把旧技能取出来用。他们用的是不更新参数的 GPT-4(黑盒)。
提出的三个互相嵌套的概念
-
自动课程
根据当前状态并结合已经成功和失败的任务清单,为自己去提出下个新鲜、又有能力达到的小目标。
-
技能库
一旦某个任务被评价成功,就把它用的可执行代码存进技能库。
这些技能不是模糊的文字描述,而是真正能调用的函数。每一条还会附一段用自然语言写的说明,说明会被转成嵌入向量做索引。面对新任务时,系统用同样的方式把任务描述也变成向量,拿出最相近的五条旧技能。
注:voyager 提出的是「代码化、可检索、可组合的技能库 + 自动课程 + 迭代代码自修复」这套开放世界终身学习 Agent 范式,它是后来很多 Code Agent / Skill Agent 的源头。
新技能常会调用库里已有的更简单技能,后期组合也更多更嵌套。这跟只把失败原因写进提示词的 Reflexion 不同:Voyager 积累的是能再执行的能力,而不只是教训。
-
迭代式提示
利用三类信息去修改程序
1)环境反馈
2)执行报错
3)自我核对
三者合在一起,就是一个无人工教学大纲的自我训练闭环:课程负责“接下来学什么”,迭代提示负责“把这一次学会”,技能库负责“把学会的东西留住并在以后用上”。
优点和局限
- 优点:Voyager 把“进步”从单次任务里的反思,推到了持续、可复用、能自己决定学习顺序的能力积累。
- 局限:依赖模型,模型会有幻觉。Voyager 改的是自己的“技能程序”,不是它用来测试和改进自身的那套智能体框架;它也没有去调整底座大模型的权重。
Voyager 在Reflexion的基础上,把成功经验编成可重用的代码技能,并自己安排下一门课。它在实验里就把 Reflexion 当作了对照之一。3. 自我改进的编码与工具智能体
3.1 Darwin Gödel Machine
前面两篇已经说明:智能体可以从失败里写下教训(Reflexion),也可以把学会的本事存成技能(Voyager)。但它们改的,大多还是“这一次怎么完成任务”。Darwin Gödel Machine(DGM)问的是更彻底的一层:智能体能不能改自己这套程序——工具怎么用、要不要多试几次、上下文太长了怎么管理——然后用真实成绩检验这次自我改造有没有变得更好?
注:2007 年,Schmidhuber 提出过“哥德尔机器”(Gödel Machine):一个理论上可以改写自身代码的系统。它有一条极严的门槛:只有当你能证明这次改写以后会更好,才允许动手。也就是只有当它找到形式化数学证明,证明这次改写能提升长期期望效用时,才执行改写;不是试出来的,是证出来的。
第一层:不必先证明,但必须拿真实任务来验
DGM 仍然让智能体改自己的代码,可是它不再要求形式化证明。一次自我改写能不能留下来,取决于它在编程基准上的实际表现,也就是改完之后通过真实的任务去测评验证是否有提示。
第二层:不只保留当前最好的一个,而是保存整个家族树
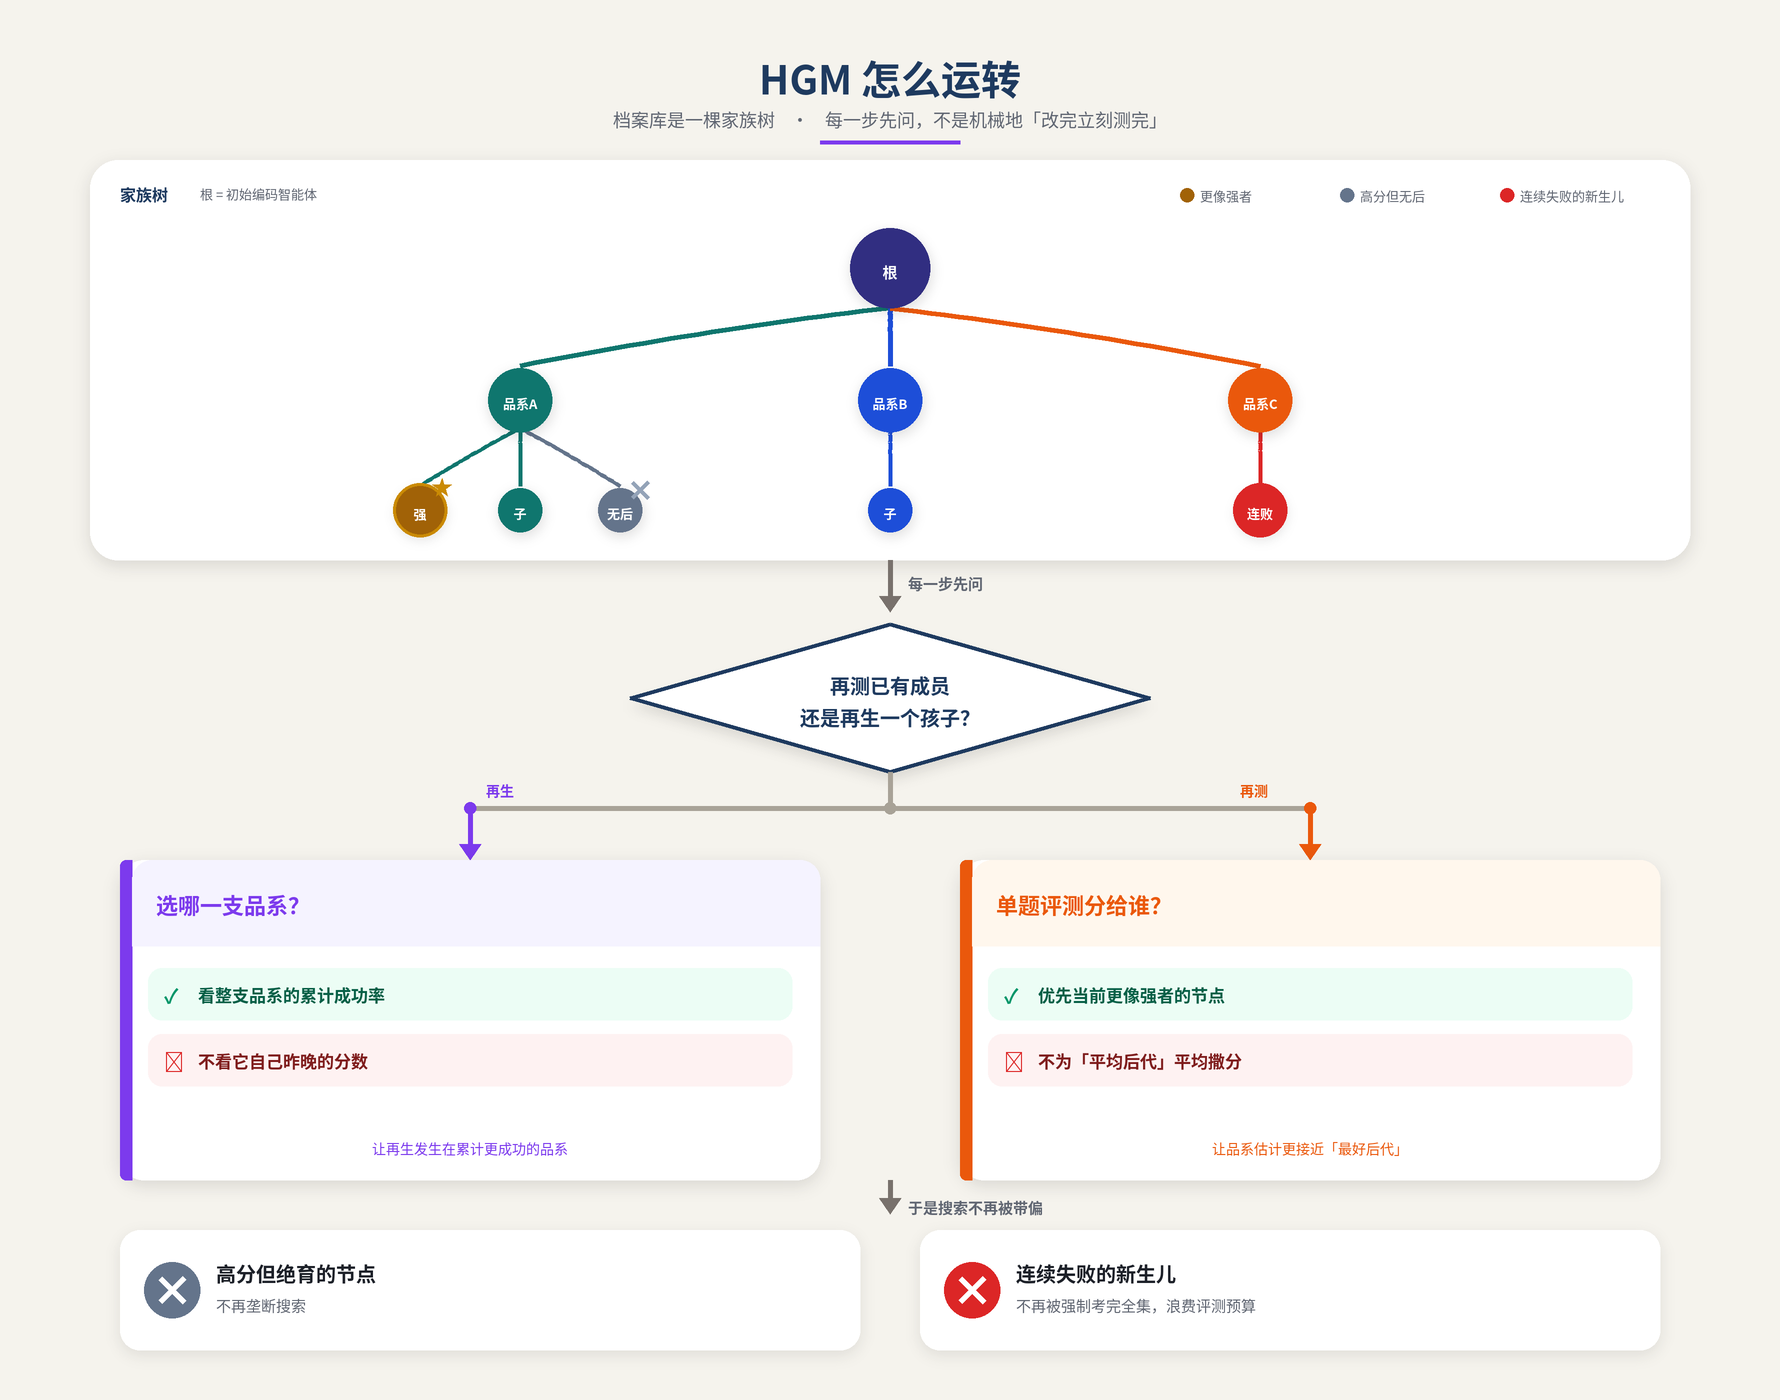
如果每次都只改“现在最好的那一个”,搜索很容易走进死胡同:某个看起来一般的分支,也许再往下走两步会突然变得很好,却因为暂时分数不够就被丢掉了。DGM 因此维护一个档案库,把历史上出现过、并且仍然能运行、能自我修改的智能体都留下来。
优点和局限性
- 优点:DGM 把问题从“完成任务时如何反思或存技能”,推进到了“如何改写自己的实现,并用经验而不是证明来决定留下来的是什么”。它把一个几乎无法落地的理论梦想(必须先证明改写有益的哥德尔机器),换成了一条可以跑起来的工程路径:在沙箱里试,用基准验,用档案库保存多样性。
- 局限:
- 一次像样的运行非常贵、非常慢。评价完全依赖于基准是否公正、是否会被钻空子;
- 如果考卷本身有漏洞,自我进化也可能往投机方向走。
- 底座模型是冻住的,所以它再怎么改,也超不出这个模型的理解能力天花板。
- 探索过程本身还不能被自我修改。
- 安全上虽然有沙箱和人工监督,但一个能改自己代码的系统,仍然需要被当成高风险对象来看待。
上一篇 Darwin Gödel Machine(DGM)已经说明:编码智能体可以改自己的代码,用编程基准做经验检验,再用档案库保留多种品系。但 DGM、SICA 这类方法在生长“自我改写之树”时,几乎都默认一件事——谁在基准上分数更高,谁就更值得继续被改写。
3.2 Huxley-Gödel Machine
在只能看到部分评测结果、计算预算有限的情况下,怎样估计一个节点的长期自我改进潜力,并据此决定下一步该扩展谁、该再测谁?
什么是元生产力
作者把智能体的“自我改进潜力”叫做 metaproductivity(元生产力)。它问的不是“你现在会不会修这个 bug”,而是:“从你出发继续改写,将来整棵搜索树最终能选出多好的智能体?”
如果把整棵树都算进去,得到的是 Global Metaproductivity(GMP):选中某个节点去扩展,对整棵档案库最终结果有多大贡献。GMP 很完整,但太难估计——一次改写甚至可能通过新信息间接影响树上其他分支。
什么是 Clade-Metaproductivity(CMP)
只看以某个智能体为根的子树,也就是它的后代家族。Clade-Metaproductivity(CMP)衡量的是:在这个支系内部,最终最好的那个后代,期望能达到多高的效用。
如何估计CMP
真实 CMP 拿不到,HGM 用品系内所有评测成败的加权比例来估计:
某个节点的「估计 CMP」= 其品系里成功评测次数 /(成功 + 失败)。
因为评测多的、表现好的节点会被评价策略更频繁地点到,这个加权平均会偏向品系里的“软最大值”,而不是只看祖先自己的即时分数。
如何决策
- 扩展还是再评测:借鉴无穷臂老虎机里的 UCB-Air 思想,当已有评测次数相对现有节点数足够多时,才开新节点;否则继续把评测预算投给已有智能体。
- 扩展谁:用 Thompson Sampling,按各节点的品系成败统计抽样,并随剩余预算收紧探索。
- 再评测谁:同样用 Thompson Sampling,但按单个智能体自己的成败统计,优先把更多单题评测分给看起来更强的节点。
最后预算用尽时,返回后验效用高分位数最好的那个“best-belief”智能体。扩展与评测解耦之后,还可以异步并行:有空闲 CPU 就立刻开下一轮,不必等“生完孩子立刻把整套考卷考完”的死板节奏。这也是它比 DGM/SICA 更省分配 CPU 小时的原因之一。
优点和局限性
- 优点:HGM 把 DGM 打开的“经验驱动自我改写”再往前推了一步:自我改进搜索的关键瓶颈,往往不在“会不会改代码”,而在“用什么信号决定改谁”。它用品系级元生产力替换即时分数,并在特定假设下把这条路连回哥德尔机器。
- 局限:
- CMP 估计依赖已有评测样本,早期树很浅时噪声大;
- 异步实现还会引入“先跑完的简单题抬高经验均值”等偏差,作者在附录里承认了这一点。
- 理论结果依赖可重复评测、目标只看最终智能体等假设,和真实世界里“只活一次、环境会变、证明也耗时”的原始哥德尔机器设定并不等同。
- 实验成本仍然极高。安全上同样需要沙箱与人工监督。
- 此外,HGM 优化的仍是冻住底座模型之上的编码智能体脚手架,不是模型权重本身。
- reflexion 用语言记下“这次怎么错”;
- Voyager 把环境里学会的本事编成可调用技能,并自己安排下一课。
- DGM 则把改写对象从“任务策略”换成了“智能体自己”,并用种群档案避免只沿着一条线爬山。三者可以看成同一条自进化阶梯上的三层:口头复盘、技能沉淀、以及经验驱动的自我重写。
- HGM 指出 DGM/SICA 仍过度依赖即时基准分,提出 CMP 作为长期自我改进潜力的品系级指标,并据此重构扩展/评测策略。可视为 DGM 路线在“搜索指导信号”上的直接后续。
评论 0
评论保存在本站服务器,无需登录。带「作者」标识的是站主回复,请友善交流。
还没有评论,来写第一条。